Análise Estatística de Dados
Para investigação e estudos de mercado
Inteligência Artificial na investigação científica:os detetores de IA funcionam mesmo e um artigo pode ser retratado por usar ChatGPT?
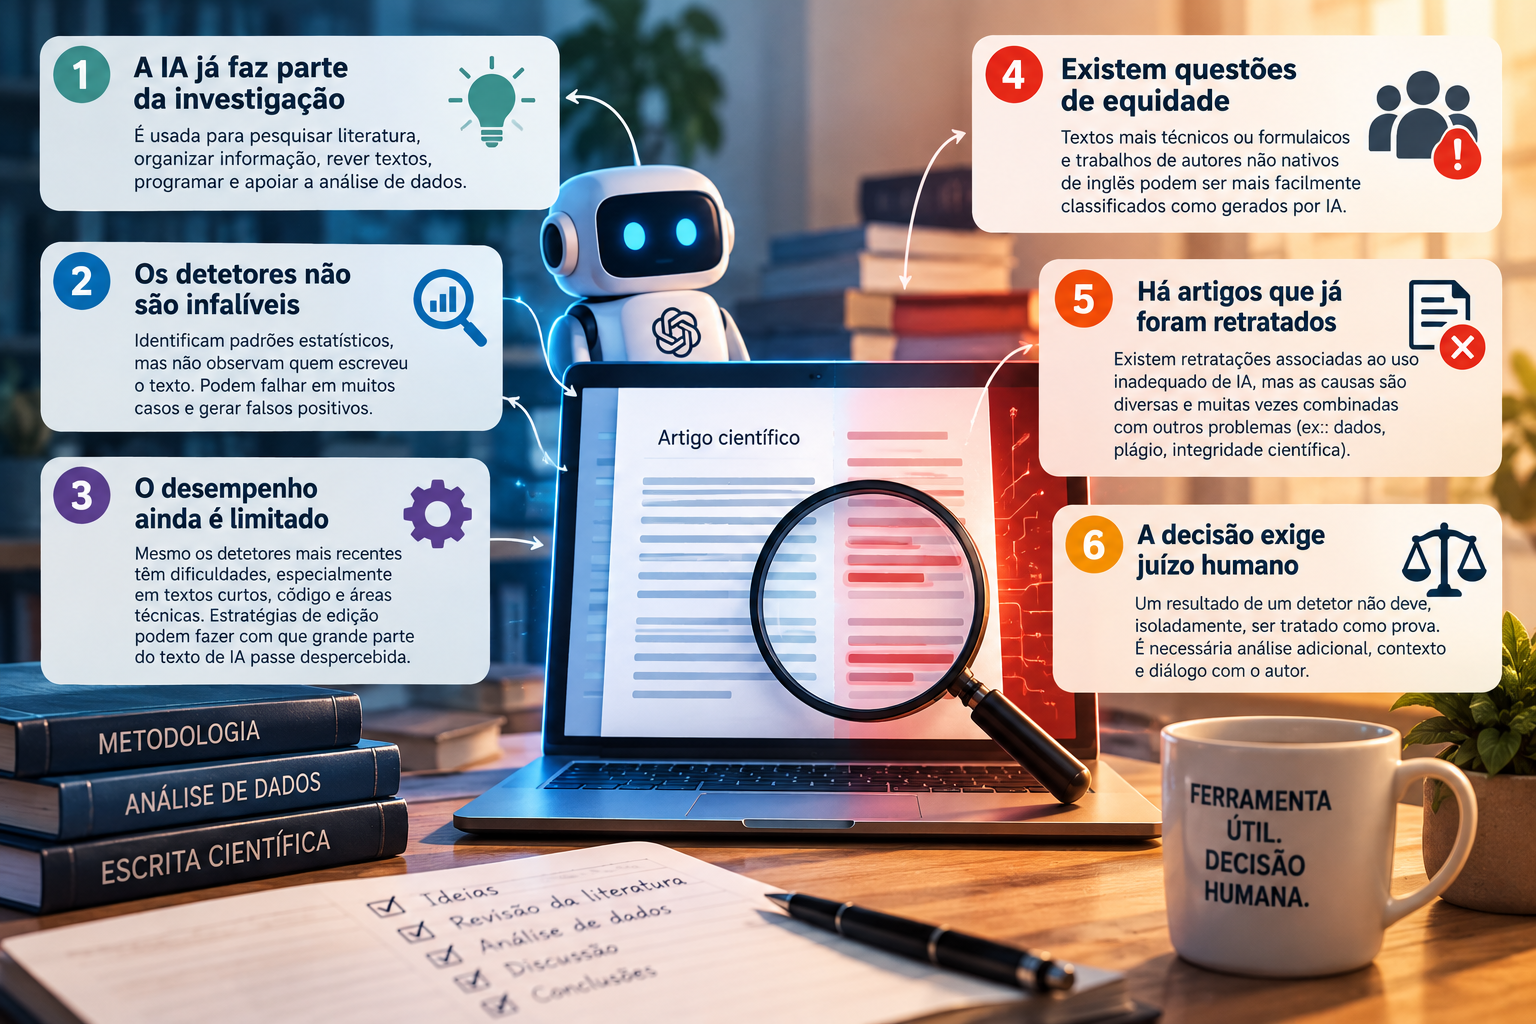
1. A IA já está na investigação. A questão é saber como a usamos.
Há pouco tempo, discutir inteligência artificial na investigação científica ainda parecia uma conversa sobre o futuro. Hoje já não é assim. A IA entrou no trabalho de estudantes, investigadores e profissionais: aparece na pesquisa bibliográfica, na organização de informação, na revisão de texto, na programação e, inevitavelmente, também na análise de dados.
Por isso, a pergunta «devemos usar IA?» começa a ser pouco útil. A questão que realmente interessa é outra: até onde podemos confiar nela e onde é que continua a ser indispensável o julgamento de quem está a fazer o estudo?
E convém não confundir uma resposta convincente com uma resposta correta. Uma ferramenta pode escrever muito bem e, ao mesmo tempo, inventar uma referência, interpretar mal um artigo ou sugerir uma análise que não faz sentido para aquele desenho de investigação. O mesmo cuidado vale para os detetores de IA: um número apresentado com duas casas decimais pode transmitir uma sensação de precisão que o método, na realidade, não tem.
No fundo, a IA pode ajudar bastante. Mas alguém continua a ter de perceber o problema, confirmar as fontes, tomar decisões metodológicas e assumir a responsabilidade pelo resultado final. É aí que o investigador — e, quando a análise o exige, o analista — continua a fazer a diferença.
2. Afinal, um detetor consegue saber se um texto foi escrito por IA?
A resposta mais prudente é: consegue tentar identificar padrões, mas não consegue observar quem escreveu o texto. Parece uma diferença pequena, mas não é.
Os detetores trabalham com probabilidades e características do texto. Não assistiram ao processo de escrita, não sabem quantas versões existiram e não conseguem reconstruir com certeza se uma determinada passagem nasceu de uma pessoa, de um modelo de linguagem ou de uma combinação dos dois.
Um dos estudos mais conhecidos sobre este problema é o de Weber-Wulff et al. (2023). Os autores testaram 12 ferramentas públicas e dois sistemas comerciais. Na discussão dos resultados estes autores afirmam que todas ficaram abaixo de 80% de accuracy e apenas cinco ultrapassaram 70%. Aproximadamente 20% dos textos produzidos por IA seriam classificados como humanos. Depois de edição ou paráfrase, essa proporção aproximou-se de 50%.
E há o problema inverso: acusar IA onde ela não existiu. No mesmo estudo, os falsos positivos variaram entre 0% e 50%, dependendo da ferramenta, e os falsos negativos entre 8% e 100%. É por isso que os próprios autores defendem que o resultado de um detetor não deve, isoladamente, servir para acusar um estudante de fraude. É necessária análise adicional e diálogo com o autor do trabalho (Weber-Wulff et al., 2023).
Ou seja, quando um software apresenta «80% de IA», isso não deve ser lido como se tivesse descoberto que 80% do texto foi escrito pelo ChatGPT. É uma classificação produzida por um modelo, com todas as limitações que isso implica.
3. E os detetores mais recentes? O problema continua.
Poderíamos pensar que estes resultados já estão ultrapassados porque os detetores evoluíram. O problema é que estudos muito mais recentes continuam a encontrar limitações importantes.
Sun, Liao e Ma (2026) fizeram uma avaliação particularmente grande: utilizaram mais de 280 mil amostras académicas reais, incluindo trabalhos, teses e código, e testaram 13 detetores comerciais e open-source. O desempenho não foi uniforme. Algumas teses longas eram classificadas com maior sucesso, enquanto trabalhos curtos e código de engenharia criavam dificuldades sistemáticas.
Há ainda outro dado que merece atenção. Uma estratégia híbrida de edição permitiu que até 88% do conteúdo produzido por IA escapasse à deteção. A conclusão dos autores é bastante clara: estas tecnologias ainda não são suficientemente robustas para suportarem, sozinhas, decisões educacionais de elevado impacto (Sun et al., 2026).
Isto ajuda a perceber por que razão dois textos semelhantes podem receber classificações muito diferentes — e por que razão o mesmo texto pode ter resultados diferentes consoante a ferramenta utilizada. O género do texto, a disciplina, a extensão e a forma como foi revisto contam.
Existe também uma questão de equidade. A literatura discutida por Sun et al. (2026) indica que escrita mais técnica ou formulaica e textos de autores não nativos de inglês podem ser particularmente vulneráveis a classificações erradas. Quando um resultado destes é utilizado num contexto académico, um falso positivo deixa de ser apenas uma curiosidade estatística.
3.1. O falso positivo não é igual para toda a gente
Há um ponto que merece mais espaço porque muda bastante a forma como devemos olhar para estes resultados. Um falso positivo não é apenas um erro do software. Dependendo de quem escreveu o texto, pode acontecer com muito mais frequência.
Liang et al. (2023) testaram sete detetores muito utilizados em 91 textos TOEFL escritos por autores não nativos de inglês e em 88 textos de estudantes norte-americanos. Nos textos dos autores não nativos, a taxa média de falsos positivos foi de 61,3%. Nos textos dos falantes nativos, pelo contrário, a classificação foi praticamente perfeita. Mais ainda: 19,8% dos textos TOEFL foram classificados como sendo de IA por todos os detetores avaliados.
A explicação ajuda a perceber o problema. Muitos detetores utilizam medidas relacionadas com a previsibilidade do texto, como a perplexidade. Um vocabulário menos variado ou estruturas linguísticas mais previsíveis podem, assim, aproximar estatisticamente um texto humano daquilo que o algoritmo espera encontrar num texto produzido por IA. Quando Liang et al. (2023) melhoraram artificialmente a diversidade vocabular dos textos dos autores não nativos, a taxa média de falsos positivos caiu de 61,3% para 11,6%.
Isto torna a questão muito menos abstrata. Giray, Roe e Espiritu (2026) chamam a atenção para as consequências pedagógicas deste tipo de erro. Os autores descrevem como estudantes multilingues podem sentir-se pressionados a alterar a sua forma natural de escrever simplesmente para não parecerem «demasiado previsíveis» para um detetor. O paradoxo é evidente: uma ferramenta criada para proteger a integridade académica pode acabar por penalizar escrita genuína e incentivar os estudantes a escrever de forma menos natural.
Por isso, falar de equidade aqui não é exagero. Se a probabilidade de ser sinalizado depende, em parte, do perfil linguístico de quem escreve, então o score do detetor não pode ser interpretado fora desse contexto.
3.2. O tipo de trabalho também muda o resultado
Outra razão para desconfiar de um número isolado é que a capacidade de deteção não se mantém igual de área para área. O próprio Sun et al. (2026) encontrou diferenças importantes entre disciplinas. Nos textos STEM, os falsos positivos e os falsos negativos foram mais problemáticos do que nas Humanidades e Ciências Sociais. Os autores relacionam este resultado com características muito próprias da escrita científica e técnica: objetividade, precisão, terminologia especializada, voz passiva e estruturas mais formulaicas podem aproximar estatisticamente um texto humano dos padrões que alguns detetores associam à IA.
E quando saímos do texto corrido e passamos para programação, o problema torna-se ainda mais evidente. Pan et al. (2024) avaliaram cinco detetores utilizando um conjunto construído a partir de 5.069 problemas e soluções em Python, com diferentes variantes de prompts para gerar código através do ChatGPT. A conclusão foi pouco animadora para quem procura uma solução universal: os detetores apresentaram dificuldades em distinguir código escrito por pessoas de código gerado por IA.
Isto interessa porque um trabalho académico não é uma categoria única. Uma dissertação em Psicologia, um relatório de Engenharia, um artigo biomédico e um exercício de programação têm estilos, estruturas e vocabulários muito diferentes. Aplicar o mesmo limiar e interpretar o mesmo score da mesma maneira em todos estes contextos é, no mínimo, discutível.
Há ainda uma consequência prática. Se o desempenho varia com a disciplina, a extensão do texto, a complexidade da tarefa e o grau de edição humana, então não existe um «80% IA» com significado universal. Esse número só pode ser entendido à luz do detetor utilizado e do contexto em que foi produzido. É mais uma razão para o tratar como um sinal a investigar e não como um veredito.
4. Curiosamente, nós também não somos grandes detetores.
Os humanos também se enganam, e bastante. Gao et al. (2023) colocaram lado a lado 50 abstracts reais de revistas médicas de elevado impacto e 50 abstracts produzidos pelo ChatGPT. O detetor utilizado no estudo teve um AUROC de 0,94, sensibilidade de 86% e especificidade de 94%. À primeira vista, são resultados fortes.
Mas quando entraram avaliadores humanos, a história ficou menos confortável. Identificaram corretamente apenas 68% dos abstracts gerados e classificaram erradamente 14% dos abstracts científicos reais como tendo sido produzidos pelo ChatGPT.
Este estudo também ajuda a desfazer uma confusão muito comum: deteção de IA não é deteção de plágio. Um texto pode ter sido gerado por IA e apresentar pouca semelhança com textos já publicados. Portanto, um resultado baixo num software de similaridade não prova autoria humana; da mesma forma, um score elevado num detetor de IA não prova, sozinho, autoria artificial.
4.1. Basta mexer no texto para o detetor começar a perder-se
Há outra dificuldade que aparece repetidamente nos estudos: os detetores funcionam melhor quando recebem exatamente o tipo de texto que esperam encontrar. Assim que esse texto é revisto, parafraseado ou misturado com intervenção humana, a fronteira começa a ficar muito menos clara.
Krishna et al. (2023) fizeram um teste particularmente interessante. Utilizaram um modelo de paráfrase chamado DIPPER sobre textos produzidos por diferentes modelos de linguagem e verificaram que a paráfrase conseguia contornar vários sistemas de deteção, incluindo GPTZero, DetectGPT e o classificador da OpenAI. Num dos exemplos apresentados pelos autores, a accuracy do DetectGPT caiu de 70,3% para apenas 4,6%, mantendo-se uma taxa de falsos positivos de 1% e sem alteração substancial do significado do texto.
Este resultado é importante porque a utilização real de IA raramente é tão limpa como nos testes laboratoriais. Uma pessoa pode pedir uma primeira versão, reescrever metade, mudar frases, acrescentar referências, eliminar parágrafos e voltar a reformular o texto. No fim, já não estamos perante uma escolha simples entre «texto humano» e «texto de IA». Estamos perante um texto híbrido.
O próprio estudo de Sun et al. (2026) parte deste problema. Os autores referem que a intervenção humana através de substituição de sinónimos e reestruturação de frases pode esconder as marcas estatísticas da geração automática, tornando a identificação de frases individuais muito mais difícil. Mais à frente, mostram também que o desempenho dos detetores varia com a disciplina, com a complexidade da tarefa e com o tipo de conteúdo analisado.
Isto explica uma aparente contradição: um detetor pode apresentar bons resultados num conjunto de teste controlado e, mesmo assim, ter um desempenho muito menos convincente quando é colocado perante trabalhos académicos reais.
5. Usar IA numa tese ou num artigo é proibido?
Depende. E esta resposta, embora menos apelativa, é mais correta do que um simples «sim» ou «não». As regras variam entre universidades, revistas, editoras e contextos de utilização.
Há, no entanto, um princípio que aparece repetidamente nas orientações mais prudentes: a responsabilidade continua a ser humana. Podemos utilizar uma ferramenta para apoiar determinadas tarefas, mas isso não transfere para a IA a autoria nem a responsabilidade pelo que entregamos ou publicamos.
As orientações da ETH Zurich são um bom exemplo. Distinguem a utilização de IA de plágio, mas deixam a responsabilidade no autor e recomendam que os outputs sejam verificados criticamente. Também defendem transparência sobre a ferramenta utilizada, a finalidade e as partes do trabalho em que houve intervenção da IA (pp. 2–3).
Na prática, há uma diferença enorme entre usar IA para ajudar a reorganizar uma frase e pedir-lhe que construa uma revisão da literatura, aceitar as referências sem as abrir e entregar o resultado. O problema não está apenas na ferramenta; está na forma como ela é utilizada.
6. E pode haver retratação de um artigo por causa da IA?
Sim, pode haver. Mas também aqui é preciso evitar títulos demasiado fáceis. Um artigo não é necessariamente retratado apenas porque alguém utilizou ChatGPT. Muitas vezes estão envolvidos problemas mais sérios como por exemplo a utilização não declarada ou inadequada, referências inventadas, dados ou imagens problemáticos, manipulação do processo de revisão ou outras falhas de integridade científica.
Kocyigit et al. (2025) analisaram 764 publicações relacionadas com IA que tinham sido retratadas. Entre as razões identificadas estavam problemas no peer review (n = 716), problemas com dados (n = 714), citações irrelevantes (n = 571) e utilização não ética de IA (n = 238). O tempo mediano entre publicação e retratação foi de 510 dias, variando entre 18 e 4.200 dias. Os autores salientam que as causas se sobrepõem e que muitos destes casos envolvem problemas clássicos de integridade científica, e não apenas IA.
Sridharan e Sivaramakrishnan (2026) analisaram 335 artigos relacionados com IA que tinham sido retratados. Entre os casos com data disponível, 46,3% das retratações ocorreram em 2023 e o tempo mediano até à retratação foi de 550 dias. Há ainda um dado particularmente interessante: 51,1% apresentavam field citation ratios superiores a 1. Ou seja, um artigo problemático pode continuar a deixar rasto na literatura mesmo depois de ser retratado.
6.1. Retratação não significa automaticamente «foi o ChatGPT»
Este ponto merece ser reforçado porque é muito fácil olhar para o aumento das retratações relacionadas com IA e concluir que estamos perante centenas de artigos retirados simplesmente por terem usado uma ferramenta generativa. Os dados não permitem fazer essa leitura.
Tiwari, Bharti e Shimray (2026) analisaram 441 artigos retratados na área da inteligência artificial, cruzando informação da Scopus com a Retraction Watch Database. Mais de metade das retratações identificadas no conjunto analisado ocorreu em 2023: 234 casos, correspondentes a 53,06%, seguindo-se 2024 com 85 casos (19,27%).
Mas o mais interessante está nas razões. Os autores encontraram um conjunto bastante heterogéneo de problemas: dados e resultados não fiáveis, manipulação, fake peer review, conflitos de autoria, questões éticas, duplicação, plágio e erros, além de problemas associados a conteúdo produzido ou apoiado por computador. No enquadramento apresentado pelos autores, as preocupações relacionadas com dados, imagens, referências, proteção de participantes e conteúdo computer-aided ou computer-generated representaram, em conjunto, 42,3% das razões identificadas .
Isto ajuda a colocar as coisas no lugar. A IA introduziu novos riscos, sem dúvida, mas muitos artigos continuam a ser retratados por problemas que já existiam muito antes do ChatGPT: manipulação, revisão por pares comprometida, paper mills, autoria problemática, dados pouco fiáveis ou violações éticas. A tecnologia mudou parte do problema; não inventou todo o problema.
Também é por isso que uma política científica séria não pode resumir-se a passar manuscritos por um detetor. Tiwari et al. (2026) defendem regras éticas mais fortes antes da submissão e chamam a atenção para responsabilidades que atravessam autores, instituições, revistas e processos editoriais. A integridade científica é um sistema. Um software de deteção pode, no máximo, ser uma peça desse sistema.
Esta distinção é importante para o próprio título deste artigo: sim, um trabalho pode acabar retratado num contexto em que houve utilização inadequada de IA. Mas a pergunta correta não é apenas «foi usado ChatGPT?». É «o que aconteceu ao rigor, à transparência, aos dados, às fontes e à responsabilidade científica?»
7. Há ainda uma ironia: a própria IA pode não perceber que uma fonte foi retratada.
Para quem utiliza IA na revisão da literatura, este é provavelmente um dos riscos mais fáceis de ignorar. Encontrar uma referência não chega. É preciso saber se ela existe, se diz realmente aquilo que estamos a afirmar e se continua cientificamente válida.
Labenbacher et al. (2026) testaram ferramentas generalistas e ferramentas orientadas para investigação utilizando 15 artigos retratados. Nenhuma lidou de forma correta e consistente com todos os casos. O melhor desempenho global foi do ChatGPT 5, que acertou as cinco tarefas propostas em 8 dos 15 artigos, ou 53,3%. Ferramentas desenhadas especificamente para investigação também falharam em identificar ou tratar corretamente parte da literatura retratada.
É um bom lembrete de uma regra simples: uma referência sugerida por IA deve ser tratada como uma pista, não como uma fonte já validada. Eu verificaria sempre três coisas: se o artigo e o DOI existem; se o artigo sustenta efetivamente a afirmação que estamos a fazer; e se entretanto foi corrigido, alvo de expressão de preocupação ou retratado.
8. Na análise de dados, o problema nunca foi apenas carregar no botão.
É aqui que a discussão sobre IA se cruza diretamente com a análise estatística. Uma ferramenta pode sugerir um teste t, uma ANOVA, uma regressão ou até um modelo de equações estruturais em poucos segundos. Isso não significa que tenha percebido o estudo.
Antes de executar qualquer teste há perguntas que continuam a exigir conhecimento do problema: como foram recolhidos os dados? Que tipo de variáveis temos? Há observações dependentes? Existem valores omissos ou outliers relevantes? O instrumento mede realmente o constructo pretendido? Os pressupostos da análise estão cumpridos? E, sobretudo, o resultado permite responder à pergunta de investigação?
Uma recomendação da IA pode ser tecnicamente plausível e estar errada para aquele desenho. Pode ignorar dependências entre observações, confundir níveis de medida ou transformar uma associação numa conclusão causal que os dados não permitem. Por isso, na investigação quantitativa, vejo a IA sobretudo como uma ferramenta de apoio: pode ajudar a explorar possibilidades, rever sintaxe, explicar procedimentos ou organizar resultados. A decisão metodológica e a interpretação final continuam a precisar de alguém que perceba o que está a fazer.
Na investigação qualitativa acontece algo semelhante. A rapidez com que uma ferramenta consegue organizar texto ou sugerir códigos não substitui coerência metodológica, reflexividade e interpretação. Em ambos os casos, produzir um output é a parte fácil. Saber se esse output faz sentido é outra história.
9. Uma regra simples para trabalhar com IA sem perder o controlo do estudo
Há tarefas em que a IA pode ser genuinamente útil: explorar palavras-chave, ajudar a organizar uma pesquisa, rever a clareza de um texto, apoiar programação ou sintaxe e explicar procedimentos. O cuidado começa quando passamos de apoio para decisão.
Eu não deixaria a ferramenta decidir sozinha quais fontes são cientificamente válidas, se uma referência sustenta determinada afirmação, qual análise é adequada ao desenho, se os pressupostos foram cumpridos ou até onde os resultados podem ser interpretados. Também não confiaria apenas nela para determinar se um artigo foi corrigido ou retratado.
Uma boa utilização da IA não consiste em retirar o investigador do processo. Pelo contrário: quanto mais poderosa é a ferramenta, mais importante se torna saber verificar aquilo que ela produz.
9.1. Talvez estejamos a tentar detetar a coisa errada
Quanto mais se lê sobre o assunto, mais fica a sensação de que existe um problema de fundo: estamos a tentar resolver uma mudança no modo de produzir conhecimento olhando apenas para o produto final.
Giray et al. (2026) defendem precisamente uma mudança de foco. Em vez de transformar a avaliação numa espécie de vigilância tecnológica, propõem abordagens mais centradas no processo, na literacia em IA e na capacidade do estudante explicar e defender o trabalho que realizou. Para estes autores, a dependência excessiva dos detetores pode prejudicar a confiança entre estudantes e docentes e afetar particularmente estudantes multilingues.
Esta ideia também aparece, por outro caminho, em Sun et al. (2026). Os autores argumentam que a avaliação no ensino superior terá de prestar cada vez mais atenção ao percurso de raciocínio e não apenas ao documento entregue. Se a IA consegue simular com facilidade um produto final plausível, passa a ser mais informativo perceber como o estudante chegou àquele resultado, que decisões tomou, que fontes utilizou e se consegue justificar aquilo que escreveu .
Na investigação científica acontece algo semelhante. Mais importante do que tentar adivinhar se uma frase «parece IA» é conseguir reconstruir o trabalho científico: de onde vieram os dados, que referências sustentam cada afirmação, por que motivo foi escolhido determinado método e quem verificou os resultados. É uma abordagem menos espetacular do que apresentar um score de 93% num ecrã, mas cientificamente é muito mais útil.
10. Conclusão
Os detetores de IA são talvez o melhor exemplo de como esta tecnologia deve ser encarada com algum equilíbrio. Podem fornecer informação útil, mas continuam sujeitos a falsos positivos, falsos negativos e estratégias de edição que alteram significativamente o resultado. Por isso, um score de deteção não deve ser tratado, sozinho, como prova de má conduta (Weber-Wulff et al., 2023; Sun et al., 2026).
Do outro lado, também não faz sentido utilizar IA como se a responsabilidade desaparecesse. Uma referência precisa de ser aberta. Um dado precisa de ser confirmado. Uma análise precisa de ser adequada ao desenho. E uma conclusão precisa de ser sustentada pelos resultados.
A IA pode poupar tempo e ajudar bastante. Mas investigação científica continua a exigir aquilo que sempre exigiu: pensamento crítico, método, conhecimento do problema e responsabilidade por aquilo que se escreve. Talvez seja justamente essa a melhor forma de a utilizar.
Referências
Weber-Wulff, D., Anohina-Naumeca, A., Bjelobaba, S., Foltýnek, T., Guerrero-Dib, J., Popoola, O., Šigut, P., & Waddington, L. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19, 26. https://doi.org/10.1007/s40979-023-00146-z
Sun, Y., Liao, Y., & Ma, X. (2026). Trusting AI to detect AI? A systematic evaluation of the reliability and robustness of current AIGC detection tools for student academic work. Computers & Education, 249, 105616. https://doi.org/10.1016/j.compedu.2026.105616
Gao, C. A., Howard, F. M., Markov, N. S., Dyer, E. C., Ramesh, S., Luo, Y., & Pearson, A. T. (2023). Comparing scientific abstracts generated by ChatGPT to real abstracts with detectors and blinded human reviewers. npj Digital Medicine, 6, 75. https://doi.org/10.1038/s41746-023-00819-6
Kocyigit, B. F., Okyay, R. A., Seiil, B., Qumar, A. B., & Sumbul, H. E. (2025). Analysis of retracted publications on artificial intelligence: Trends, ethical concerns, and scientific integrity. Journal of Korean Medical Science, 40(44), e280. https://doi.org/10.3346/jkms.2025.40.e280
Sridharan, K., & Sivaramakrishnan, G. (2026). Artificial intelligence in the retraction spotlight: Trends, causes and consequences of withdrawn AI literature through a systematic bibliometric review. Frontiers in Research Metrics and Analytics, 10, 1737168. https://doi.org/10.3389/frma.2025.1737168
Labenbacher, S., Niederer, M., Hammer, S., Bader, M., Schreiber, N., & Bornemann-Cimenti, H. (2026). Performance of AI tools in citing retracted literature: Content analysis. Journal of Medical Internet Research, 28, e88766. https://doi.org/10.2196/88766
Tiwari, S., Bharti, P., & Shimray, S. R. (2026). Characteristics of retracted journal articles in artificial intelligence. DESIDOC Journal of Library & Information Technology, 46(3), 316–325. https://doi.org/10.14429/djlit.21055
ETH Zurich. (2024). Guidelines on the use of generative AI in scientific work.
Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
Krishna, K., Song, Y., Karpinska, M., Wieting, J., & Iyyer, M. (2023). Paraphrasing evades detectors of AI-generated text, but retrieval is an effective defense. Advances in Neural Information Processing Systems, 36, 27469–27500. https://doi.org/10.52202/075280-1195
Giray, L., Roe, J., & Espiritu, J. D. (2026). AI writing detectors are ineffective, unreliable and harmful. English Teaching: Practice & Critique. https://doi.org/10.1108/ETPC-07-2025-0155
Pan, W. H., Chok, M. J., Wong, J. L. S., Shin, Y. X., Poon, Y. S., Yang, Z., Chong, C. Y., Lo, D., & Lim, M. K. (2024). Assessing AI detectors in identifying AI-generated code: Implications for education. In Proceedings of the 46th International Conference on Software Engineering: Software Engineering Education and Training (pp. 1–11). https://doi.org/10.1145/3639474.3640068
PRECISA DE APOIO NA SUA INVESTIGAÇÃO?
A Inteligência Artificial pode ser uma ferramenta útil, mas não substitui uma análise metodológica rigorosa nem a interpretação adequada dos resultados.
Na Análise Estatística, prestamos apoio personalizado a estudantes, investigadores e profissionais na preparação e tratamento de bases de dados, escolha dos métodos estatísticos, análise quantitativa e qualitativa, interpretação dos resultados e apresentação científica.
Tem dúvidas sobre a metodologia ou análise dos dados do seu estudo?
Entre em contacto e explique-nos o seu projeto. Analisamos consigo a melhor forma de avançar.
Análise Estatística
Site: analise-estatistica.com
Email: geral@analise-estatistica.com
WhatsApp: +351 933 772 943